Czy AI potrafi zapomnieć? Prawo autorskie i RODO w czasach sztucznej inteligencji
Czy AI to tylko iluzja? Czy memoryzacja to już zwielokrotnienie? Prawo autorskie i ochrona danych osobowych w czasach pędzącego rozwoju AI to co raz większy i bardziej złożony problem. Taki też był główny temat wykładu eksperckiego zorganizowanego przez Urząd Ochrony Danych Osobowych
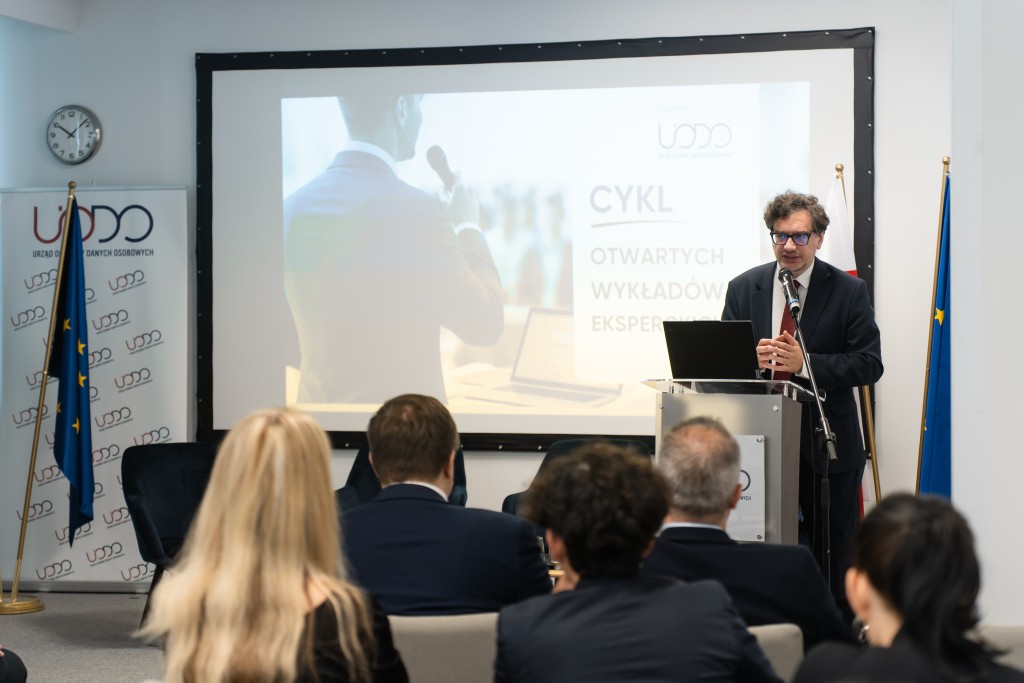
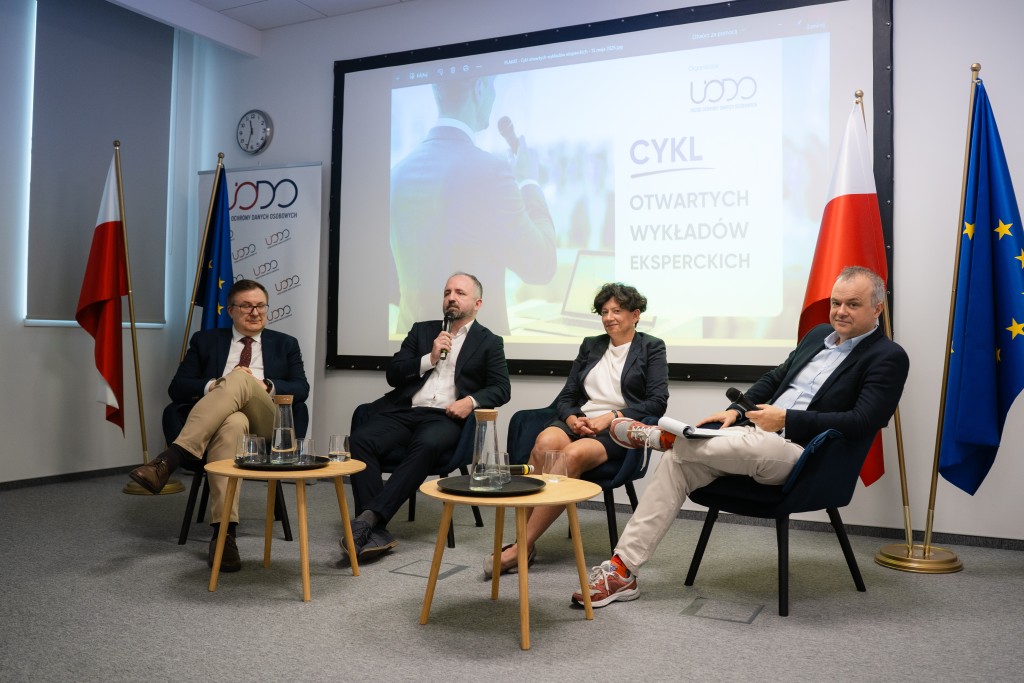
Sztuczna inteligencja a prawo – to tytuł trzeciego już trzeciego wykładu w ramach Cyklu Otwartych Wykładów Eksperckich organizowanych przez Urząd Ochrony Danych Osobowych.
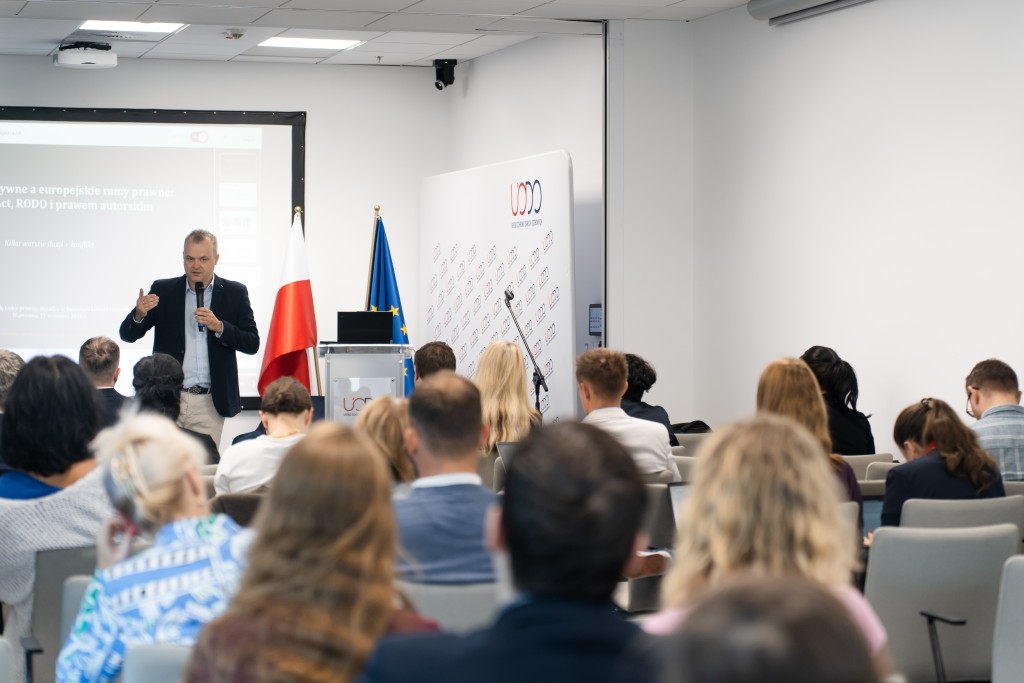
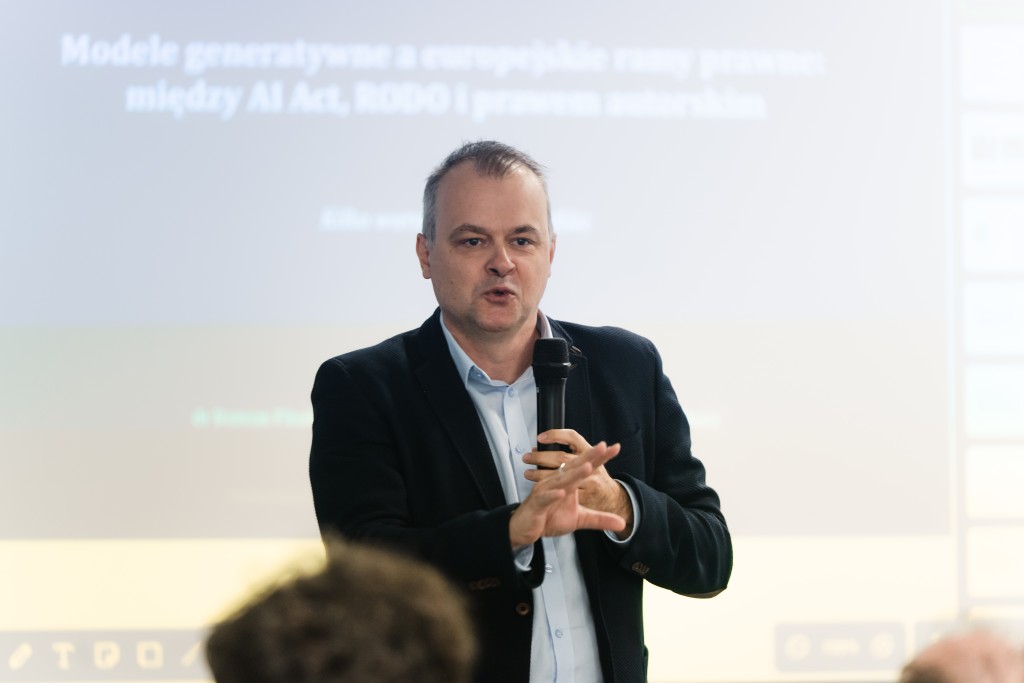
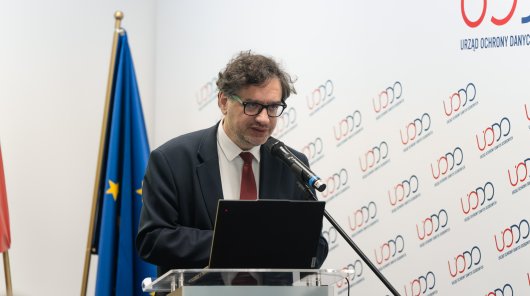
Wydarzenie, które otworzył Mirosław Wróblewski, Prezes UODO, było skupione wokół wykładu „Modele generatywne a europejskie ramy prawne: między AI Act, RODO i prawem autorskim” dr. Damiana Flisaka, radcy prawnego w Lubasz i Wspólnicy - Kancelaria Radców Prawnych. To był też pretekst do panelu dyskusyjnego pełnego pytań o prawo autorskie, ochronę danych osobowych i to, co modele generatywnej sztucznej inteligencji mogą robić z dziełami ludzi.
Prawie nikt nie jest na to gotowy
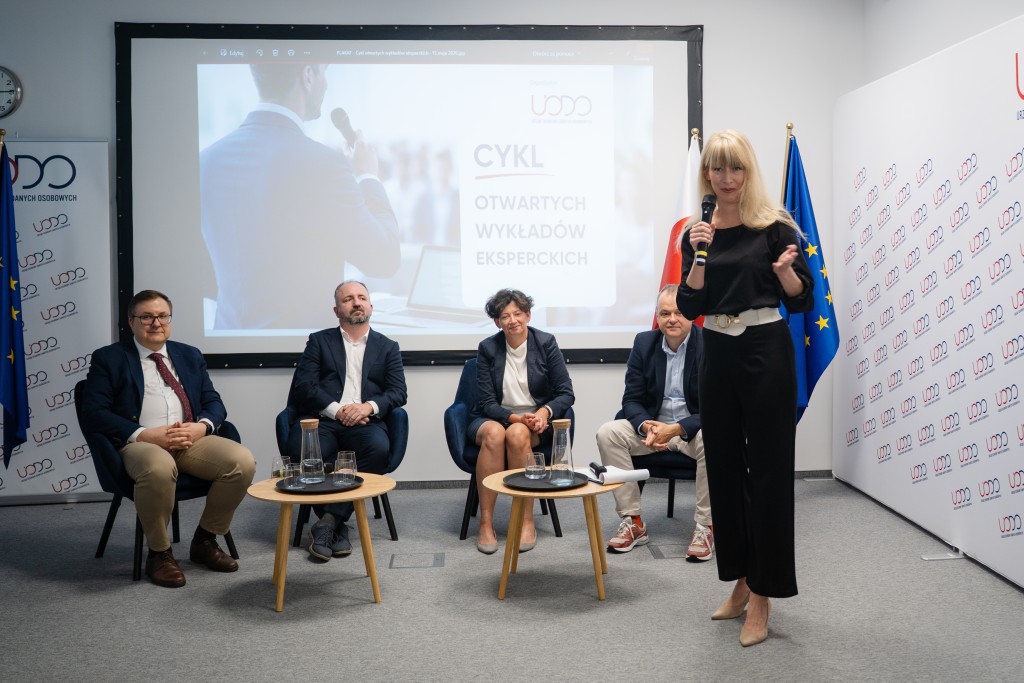
W piątek, 11 września, w siedzibie UODO w Warszawie, dyskutowali o tym:
- r. pr. Agata Szeliga, Partner w kancelarii Sołtysiński Kawecki & Szlęzak
- dr Zbigniew Okoń, Radca Prawny w Lubasz i Wspólnicy - Kancelaria Radców Prawnych
- dr Michał Araszkiewicz, Adiunkt w Katedrze Teorii Prawa, Uniwersytet Jagielloński w Krakowie
Wszystko rozpoczęło się od wystąpienia Prezesa Mirosława Wróblewskiego, który przypomniał „Raport Strategiczny - Badanie potrzeb organizacji w zakresie wykorzystania sztucznej inteligencji i ochrony danych osobowych” (Aktualności - UODO), opracowany przez Grupę roboczą ds. Sztucznej Inteligencji powołaną w ramach Społecznego Zespołu Ekspertów przy Prezesie UODO.
95,9 proc. pytanych podczas konsultacji podmiotów, nie uważało się za odpowiednio przygotowane do wdrożenia AI zgodnie z RODO. I właśnie o tej liczbie wspomniał prezes Mirosław Wróblewski podkreślając przy tym, jak – w świetle takich danych – potrzebne są takie wykłady i dyskusje.
Iluzja, antropomorfizacja i memoryzacja
Dr Damian Flisak w swoim wykładzie przedstawił prawne wyzwania związane z rozwojem generatywnej sztucznej inteligencji, ujmując je przez pryzmat „iluzji”.
Tu punktem wyjścia była niezwykła złożoność i tempo rozwoju AI. Mechanizmy działania modeli pozostają trudne do pełnego wyjaśnienia nawet dla specjalistów, a prawnicy muszą oceniać je za pomocą istniejących pojęć i regulacji.
Pierwszą przedstawioną przez dr. Flisaka iluzją jest zdolność AI do naśladowania rzeczywistości w sposób, który może skutecznie oszukiwać ludzkie zmysły. Rozwój deepfake’ów i innych treści syntetycznych powoduje, że coraz trudniej odróżnić materiały wygenerowane od rzeczywistych. Towarzyszy temu narastający społeczny sceptycyzm wobec AI i pytania o rzeczywiste korzyści z jej rozwoju oraz biznesowe motywacje największych dostawców technologii.
Drugą iluzją jest utożsamianie uczenia się człowieka z trenowaniem modeli AI. Człowiek, zapoznając się z utworem, zdobywa wiedzę, ale również zapomina. Model działa inaczej, a „oduczenie” go określonych informacji pozostaje poważnym problemem technologicznym. Antropomorfizujące pojęcia, takie jak „uczenie”, „rozumowanie”, „pamięć” czy „sieci neuronowe”, mogą dodatkowo tworzyć fałszywe analogie między człowiekiem a maszyną.
Kolejny problem dotyczy prawa autorskiego i wyjątku eksploracji tekstów i danych (TDM – text and data mining), który umożliwia wykorzystywanie utworów do trenowania modeli. W przypadku zastosowań komercyjnych uprawniony może teoretycznie zastrzec brak zgody na takie wykorzystanie jego dzieła(opt-out). Dr Damian Flisak wskazał jednak na brak jasnych i skutecznych zasad dokonywania takich zastrzeżeń, co prowadzi do znacznej niepewności prawnej.
Za kolejną iluzję prelegent uznał przejrzystość procesu trenowania modeli. AI Act przewiduje obowiązki informacyjne dotyczące danych wykorzystywanych do trenowania dużych modeli ogólnego przeznaczenia, jednak zakres ujawnianych informacji może być zbyt ogólny, aby twórcy mogli skutecznie ustalić, czy wykorzystano ich utwory.
Szczególną uwagę dr Flisak poświęcił zjawisku „memoryzacji”, czyli możliwości wygenerowania przez model treści odtwarzających dane treningowe, niekiedy także chronione utwory lub ich fragmenty.
Wykład zakończyła refleksja, że prawo mierzy się z technologią pozostającą w ciągłym rozwoju. Dlatego wątpliwości dotyczące kwalifikacji prawnej zjawisk związanych z AI nie są słabością, lecz naturalnym elementem poszukiwania regulacji odpowiadających zmieniającej się rzeczywistości.
Dyskusja i pytania
Wykład dr Damiana Flisaka okazał się doskonałym punktem wyjścia do panelu dyskusyjnego z zaproszonymi gośćmi.
Agata Szeliga mówiła między o przepisach AI Act z perspektywy przedsiębiorców czy o przepisach i rozwiązaniach dotyczących danych szczególnej kategorii.
Dr Zbigniew Okoń odpowiadał na pytanie, jak prawo autorskie radzi sobie w obecnych czasach. Sporo uwagi poświecił także artykułowi 53 ust. 1 unijnego rozporządzenia w sprawie sztucznej inteligencji (AI Act). A dr Michał Araszkiewicz skupił się na języku i nomenklaturze używanej w języku prawa w odniesieniu do AI i zjawisk z nią związanych.
Wydarzenie zakończyła seria pytań od licznie zgromadzonej publiczności.
 Karol Witowski
 2026-09-16
Edyta Madziar
2026-09-16 12:00:33
Edyta Madziar
2026-09-16 14:16:22
Galeria zdjęć